
Genomsnitt är användbara eftersom de är enkla. Men denna enkelhet är också det som gör dem missvisande.
Ta genomsnittligt ordervärde (AOV) som exempel.
Här är data från ett e-handelsvarumärke med ett AOV på 150 €. Gräver vi djupare ser vi att det finns en 100-faldig spridning mellan ordervärden, från 10 € till 1000 €.
Vi kan visualisera denna fördelning med ett histogram. Det visar att kunderna beter sig väldigt olika och att det finns väldigt få ”genomsnittliga” kunder.
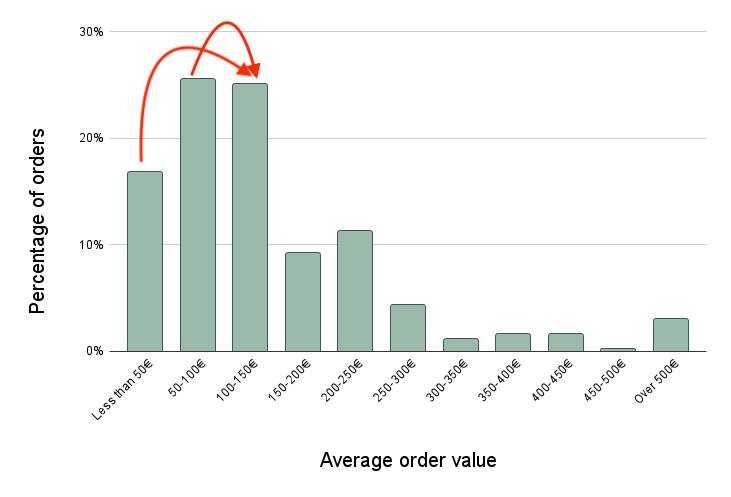
Företag sätter ofta ett mål att öka AOV med X %. Det tillvägagångssättet är inte särskilt logiskt när man tittar på det faktiska köpbeteendet.
Ett bättre tillvägagångssätt är att försöka flytta kunder från en ”hink” till nästa.
I det här exemplet handlar över 40 % av kunderna för mindre än 100 €. Kan vi flytta några av dem till 100 €+-hinken genom att till exempel erbjuda fri frakt på beställningar över 100 €?
Genomsnitt är användbara och en bra utgångspunkt. Men för att upptäcka verkliga insikter måste vi ofta titta på de enskilda datapunkterna som utgör genomsnitten.